ONNX Runtime+PP-OCRv5 と専用分類器による多段照合の設計・精度改善・検証(Delphi 12)
【この記事の概要】
■ 手書き答案から切り出した解答欄の自動採点が完全ローカルで動く新しい機能をデジタル採点ソフト MS_Reader V3 に搭載しました。ネットワーク・GPU・Python 等が不要で、Delphi 12(Win32)から ONNX Runtime の C API を直接呼び出し、1解答あたり数十ミリ秒で読み取り、採点します。人の目視による最終確認は必須ですが、それが「ない」よりは「まぁ。いいかな?」程度には動作します。
■ 設計原則は「モデルは読むだけ、○×は必ずコードで決める」です。生成AI(Vision-Language Model:VLM=大規模視覚言語モデル)に正誤を判定させる方式は、高価な機材が必要な上、採点に時間がかかり、さらに誤判定も多く、最終的に自動採点の設計方針をOCR+照合ロジックへ転換しました。
■ 五段照合と単文字専用分類器、そして「機械的な推論に迷ったら、判定は人に回す」安全弁の組み合わせで、出来る限り「誤って ○ を付けない」設計にしています。
■ 精度改善は測ってから行いました。実際の生徒の答案を人物単位で分けて検証し、効果のなかった施策(OCRの併用、公開データの追加など)は実装せず、前の学習モデルに比較して明らかに性能が向上すると認められた施策(手書き文字データの追加学習など)のみ実装しました。
■ 選択肢を絞った設問に対する現在の学習モデルの未知のデータ(機械学習には未使用の手書き文字テスト用サンプル)への正解率は、公開版の学習モデルで、
・数字(0-9):94.0%
・ひらがな(あ-こ):96.9%
・カタカナ(ア-コ):93.3%
・アルファベット大文字(ABCDE):98.2%
・アルファベット小文字(abcde):96.7%
・記号(○△×):97.0% でした。
※ 測定対象及び環境が変化すると、結果は異なると思われます。
【もくじ】
- はじめに
- 全体アーキテクチャ
- 設計原則:「モデルは読むだけ、○×はコードで決める」
- 認識エンジン:ONNX Runtime を Delphi から直接呼ぶ
- 五段照合:不一致のときに段階的に確かめる
- 単文字設問と専用分類器
- 安全設計:誤って○を付けない・なるべく自動 × にしない
- 精度をどう測り、どう改善したか
- 開発で得た教訓
- 運用と設定
- 今後の課題
- お願いとお断り
付録 AI自動採点の実際
1.はじめに
1.1 作ったもの
「MS_Reader V3」は、元々はマークシートリーダーですが、スキャンした答案画像から設問ごとの解答欄を切り出し、正解なら ○、部分点ありなら △ 、不正解なら × の各採点記号と得点等を解答欄の指定位置へ付ける、記述式答案の採点機能も搭載した、デジタル採点支援ソフトです(Delphi 12 / VCL)。今回解説するのは、そのうち記述式(手書き)の設問を一次採点する「AI自動採点」機能です。
「AI」と呼んでいますが、生成AIに判定を任せる設計ではありません。実体は、ローカルで動く軽量なOCR、単文字専用の分類器、そして照合ロジック(通常のプログラム)の組み合わせです。ですので、きちんと表現すれば『深層学習によるAI文字認識技術を搭載し、手書き答案の読み取りから正誤判定・得点計算までを自動化するAI自動採点機能(採点そのものをAIが判断しているわけではありません)を新しく作成・搭載しました』ということになるかと思います。
1.2 要件
高等学校の定期考査での使用を前提に、次の要件を満たすことを目標に作成しました。
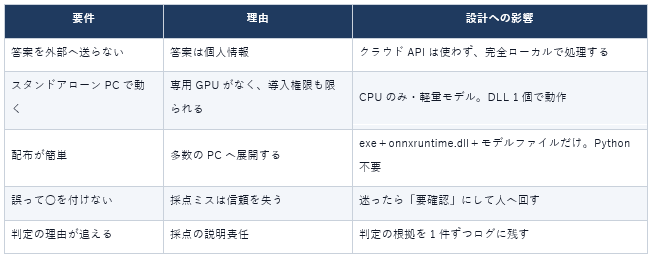
位置づけは「AIによる一次採点+プログラム側で要確認と判断した解答は人が最終確認」です。採点の完全自動化ではなく、採点者の負担を減らしつつ、判断が難しいものは人の目視による確認に戻す運用を前提にしています。
2.全体アーキテクチャ
2.1 処理の流れ
- スキャンした答案から、設問ごとの解答欄を切り出します(既存機能をそのまま利用)。
- 採点者が模範解答(別解・採点基準メモ)を登録します。TegakiAnswerKey.csv に「設問番号、模範解答、別解、採点基準メモ」の4列で保存します。
- 「AI採点」ボタンをクリックすることで、事前チェック(エンジンの初期化、模範解答の有無)と実行確認を行います。
- 解答欄を画像(可逆圧縮のPNG)にします。ほぼ白紙の解答欄は、OCRに掛けず、画素のインク比率だけで空欄と即判定します。
- ワーカースレッド(TTask.Run)で1件ずつ GradeAnswer を呼び、結果を TThread.Synchronize で画面へ反映します。
- ○×が確定したものだけを反映し、要確認は未採点のまま残してサマリーに列挙します。全判定は AI採点ログ.csv に追記します。
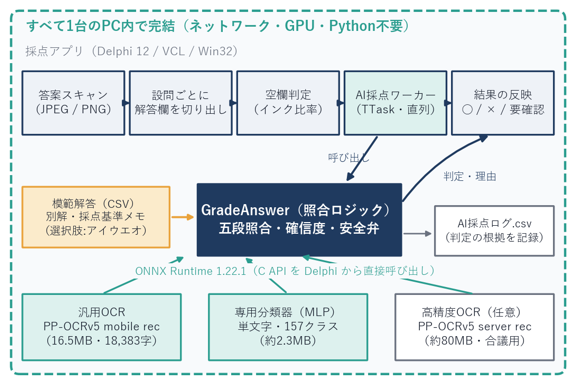
全体の構成を図1に示します。採点アプリが解答欄の画像を用意し、照合ロジックが2つの推論エンジン(汎用OCRと専用分類器)を使い分けます。
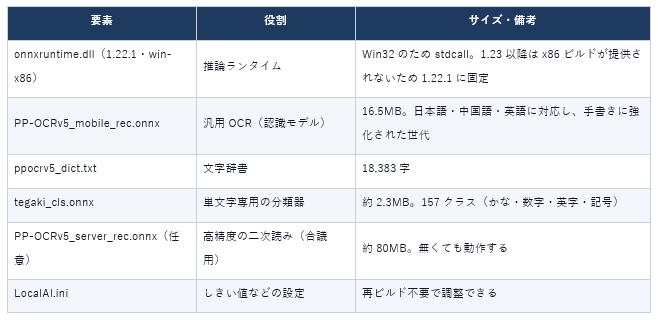
2.2 構成要素
3.設計原則:「モデルは読むだけ、○ × はコードで決める」
3.1 最初の実装:VLM(Ollama+Qwen3-VL)
開発当初は、ローカルで動くビジョン言語モデル(Vision-Language Model:Ollama+Qwen3-VL 4B)に、画像を見せて採点まで行わせる方式で自動採点機能を実装しました。導入が容易で、HTTPで呼ぶだけ、日本語の読み取りも良好でした。しかし、次の2つの問題が見つかりました。
- 圧倒的に遅い:私がテスト用に準備した環境では、1解答あたり、採点に約300〜550秒を要し、40人×1設問で採点に数時間かかることが判明。これでは使い物になりません!
- 判定が信頼できない:「光合成」と正しく読めているのに、モデルの知識で「(中国語的に?)光合作用が正しい」と考えて × にしたり、誤答「呼吸」を ○ にしたりしました。採点ログの理由欄を見ると、モデルは独自判断で答えている(採点している)ようで、模範解答と比較して「正解か・不正解か」を判定していませんでした。
独自判断を禁じるプロンプトに改良しても、この問題は解消しませんでした。
3.2 転換:OCRとコード照合の分離
そこで、モデルには文字の読み取りだけをさせ、正誤の判定と得点はコードで確定する設計に切り替えました。読み取り結果を正規化し、模範解答や別解と文字列として照合します。
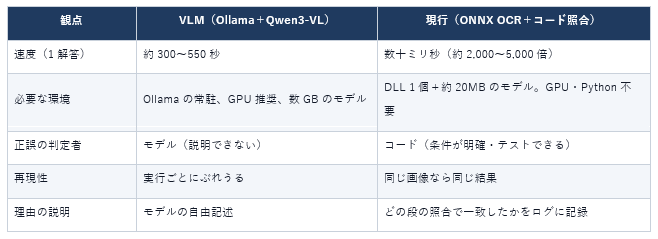
読み取りのエンジンを、VLMから ONNX Runtime+PP-OCRv5 へ換装しましたが、照合ロジックは変えていません。画面や採点の流れは無改修のまま、読み取り速度だけがなんと 数千倍! 速くなりました。
VLM 使用時は、採点を開始するとテストに使用したテスト用マシンの GPU が輝き、ファンは唸りを上げて熱をまき散らし、まさに『動いてる感』満載で、しかし、採点に気が遠くなるほど時間を要するという、傍から見守っている分には実に楽しい仕様でありながら、実用性という観点から見ると「使用不可」としか言えないシロモノでしたが、ONNX OCR + コード照合の現行方式としてからは、採点速度の圧倒的改善だけでなく、必要な環境も、実際の採点現場の環境で十分対応できるものとなり、環境的な負荷も圧倒的に軽くなりました。
4.認識エンジン:ONNX Runtime を Delphi から直接呼ぶ
4.1 C API を最小限だけバインドする
ONNX Runtime の C API(OrtApi)は、関数ポインタが並んだ巨大な構造体です。Delphi用のヘッダーはないため、構造体をPointerの配列として扱い、インデックスで関数を取り出す方式にしました。インデックスは、v1.22.1 の onnxruntime_c_api.h から機械的に抽出して検証しています(全318メンバーのうち27個を使用)。Win32では呼び出し規約が stdcall です。
// 概念コード:OrtApi は関数ポインタの並び。配列として扱い、
// ヘッダーから抽出したインデックスで目的の関数を取り出す
function TOnnxOcrEngine.ApiFunc(AIndex: Integer): Pointer;
begin
  Result := PPointerArray(FApi)^[AIndex];   // FApi = OrtApi 関数テーブルの先頭
end;
4.2 OCRパイプライン(検出モデルなし)
解答欄は既存の機能を利用して既に切り出されているため、文字領域を探す検出モデルは使わず、認識モデルだけで軽量に動かしています。
1. グレースケール化し、大津の二値化でインク領域を求めます。
2. 枠線・罫線(幅や高さの85%以上を占める直線)を白く塗って消します。
3. 行方向の射影から行帯を検出し、複数行にも対応します。
4. 各行を高さ48pxに、縦横比を保ってリサイズし、CHW形式で v/127.5 − 1 に正規化します。
5. 推論します(出力は [1, T, 18385]。時間ステップ × 文字クラス)。
6. CTC貪欲デコードで文字列にします。各時刻の最大クラスを取り、blank を除いて連続する重複を畳みます(⇨ 5.2 CTC候補照合に詳しい解説があります)。確信度は、文字単位の確率の平均です。
4.3 手書き向けの前処理強化
手書き答案の採点用に、次の前処理を行っています。
- 再帰的な大津の二値化:印刷枠線の黒が支配的だと、しきい値が黒側に寄って薄い鉛筆線が漏れる。明るい側で2回目の大津の二値化を行う。
- コントラスト正規化:紙の地を白、最も濃い部分を黒へ線形に伸ばし、薄い鉛筆や影のあるスキャンを学習時の分布に近づける。
- 傾き補正(±5°):射影の鋭さで傾きを推定して水平化。孤立した1文字では回転しないよう、発動条件を厳しくしてある。
- 細線保護:高解像度のスキャンを縮小するとき、細い線が消えないよう最小値フィルタを掛けてから縮小する。
- 短い帯のマージ:「う」「ふ」の点や「言」の上画が別の行として分割され、本体だけ誤読される問題(う→つ)を解消する。具体的には、OCRは、インクのある高さの帯を1つの「行」とみなし、例えば「う」なら、上下に隣り合う2つの帯を見て(点や上画は、本体よりずっと小さいので)片方がもう一方の45%未満の高さであり、また点は、本体のすぐ近くにあるので、2つの帯の間の隙間が、大きいほうの高さの半分未満であれば、同じ文字の一部として1つにまとめる。 一方、高さが近い2つの帯(本当に2行書いた答案)は、条件1に当てはまらないので、別々の行のままになる。専用分類器(単文字用)は、OCR とは別の仕組みで、こちらは、面積が近い塊を同じ文字とみなして結合しています(「い」の左右の画などが、これで救われる)。
5.五段照合:不一致のときに段階的に確かめる
読み取り結果が模範解答と一致しないとき、すぐに × とはせず、より強い根拠を持つ手段で順に確かめます。これが「五段照合」です。各段の内容①~⑤と全体の流れ(図2)を示します。
①「原文一致」の段:読み取りを正規化(空白除去・全角→半角・英字の大小無視・句読点無視)して、模範解答と別解に照合。採用条件は、一致で○。設定は、確信度の下限0.75
②「ラベル除去」の段:解答欄に印刷された小問ラベル(「A:」「(1)」)を正規表現で除いて再照合。原文を先に照合するので「3:2」のような正答を誤って削らない。採用条件は、英数字・かな1~3字+コロン、または括弧付き番号
②′「専用分類器」の段:候補が全て1文字の設問で、専用分類器が候補の文字種(または選択肢)の中から答えを選ぶ。採用条件は、一致かつ確信度0.60以上。設定は、確信度の下限0.75。
③「文字種制約再読」の段:候補がすべてかな(または英字)なら、その文字種だけにデコードを制約して再読。漢字への誤読を構造的に排除。採用条件は、かな全字+長音/英大小文字52字。設定は、確信度の下限0.75
④「CTC候補照合」の段:模範解答そのものをCTCの確率行列へ強制整列(Viterbi)し、各文字に割り当たった確率で評価する(閉集合照合)。採用条件は、平均適合度0.5以上かつ最低適合度0.2以上。
⑤「高精度モデル合議」の段:×を付ける前に、高精度モデルで再読。読みが割れたら、自動×にせず要確認へ。高精度読みだけが一致した場合は、要確認へまわす。
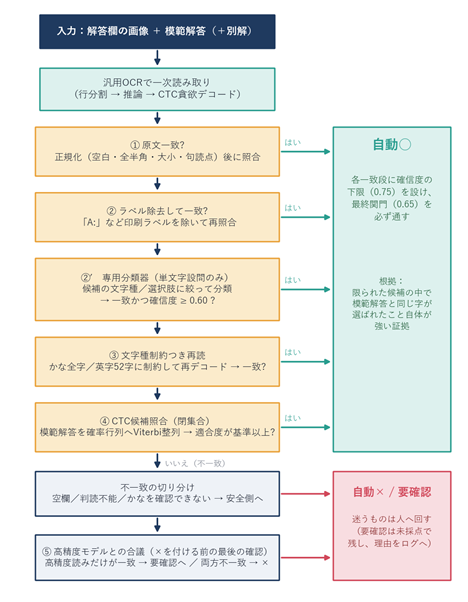
図2 五段照合の流れ(一致すれば自動○、迷えば要確認へ)
5.1 確信度の設計
AIは文字を読むとき、「どのくらい自信があるか」を数値(確信度)で出します。ところが、この数値だけで採点すると、正しく読めているのに自信が低く出て、「要確認」に回されてしまう場合が少なからずあることが(テストを行う中で)判明しました。
そこで、次の考え方を取り入れました。「選択肢の中から選んだ答えが、模範解答と同じだった場合」その事実は、AIの自信を示す数値とは別に、それ自体がとても強い正解であるという根拠になります。
そのため、模範解答と一致したときは、確信度に最低ライン(0.75)を設けました。この最低ラインは、合格ライン(0.65)より高いので、一致したものは、必ず合格ラインを超えて「自動 ○」になります。
次は、分類器の一致と確信度の下限を設定しているコードです。
// 専用分類器の一致:許可集合の中で模範解答と同じ字が選ばれ、かつゲートを超えたら採用
if MatchesAnyCandidate(NormalizeAnswer(ClsRes.Ch)) and
   (ClsRes.Confidence >= FSettings.ClassifierMatchConf) then      // 0.60
begin
  Matched := True;
  MatchNote := '専用分類';
  Result.Confidence := EnsureRange(
    Max(ClsRes.Confidence, FSettings.ClassifierMatchFloor), 0.0, 1.0);   // 下限 0.75
end;
5.2 CTC候補照合:崩れた字を「答え合わせ」で拾う
手書きが崩れると、貪欲デコード※が別の漢字を選んでしまうことがあります。しかし、確率行列の上では、正しい文字も一定の確率を持っています。④では、模範解答の文字列を確率行列に強制的に整列させ、各文字に割り当たったフレームの最大確率の平均と最小で適合度を測ります。ラベル等の余分なセグメントに邪魔されないよう、連続するセグメント範囲ごとに照合して最良を採ります。
この方式には弱点があります。整列は、候補が読み取り結果の部分列でも高スコアになります(実測では、increase と書かれた画像に対して in が0.97)。英単語の設問では、この誤自動 ○ を防ぐため、「長さ整合ガード」を入れています。
※ 貪欲デコードとは?
「貪欲(どんよく)デコード」は、AIが出した答えの候補の中から、その場その場で一番自信のあるものを選ぶだけで、文字列を作る方法です。
OCRのAIは、画像を左から右へ細かく区切り、区切りごとに「この部分は何の文字か」を、全ての文字について確率で答えます。
| 区切り | 1番目 | 2番目 | 3番目 |
| 1 | 「う」 70% | 「つ」 20% | 「ら」 10% |
| 2 | 「う」 60% | 「空白」 30% | 「つ」 10% |
| 3 | 「空白」 80% | 「う」 15% | … |
貪欲デコードは、各区切りで、1番目の候補だけを選びます。
・区切り1:「う」
・区切り2:「う」
・区切り3:「空白」
そのあと、次の2つの整理をして、文字列にします。
1.連続する同じ文字は、1つにまとめる。(「う」「う」→「う」)
2.空白(何もない部分)を取り除く。
結果は「う」になります。
「貪欲」という名前の由来は、先のことを考えず、目の前で一番良いものを選ぶという意味です。全体としてどれが最適かは、考えません。この方式の長所は、計算がとても速い(数十ミリ秒)ことですが、手書きが崩れると、区切りごとの1番目が、ずれた字になることがあるという短所もあります。この場合、そのまま誤読になります。
この弱点を補うために、貪欲デコードで一致しなかったときは、別の方法で確かめ直します。
④ CTC候補照合:貪欲デコードは使わず、「模範解答の文字が、確率の表の中でどれくらい出ているか」を直接調べます。1番目でなくても、模範解答の字が十分な確率を持っていれば、一致とみなします。
③ 文字種制約つき再読:候補を「ひらがなだけ」などに絞ってから、選び直します。
つまり、まず速い貪欲デコードで読み、迷ったら候補を絞って確かめる、という二段構えです。
5.3 判定の種類
- 自動 ○:一致した。確信度に下限を適用済み。
- 自動 ×:どの段でも一致せず、迷う要素もない。
- 要確認:判読不能、低確信度、モデル間で結論が割れた等 ⇨ 未採点のまま人の目視確認へ回す。
- 無解答:空欄と確定したもの。
どの段で判定したかは、理由文として AI採点ログ.csv に残ります(例:「専用分類器が『イ』と判定し模範解答と一致(確信度0.75)」)。
6.単文字設問と専用分類器
6.1 なぜ専用の分類器が必要か
AI自動採点で、文字列の推論に使用しているPP-OCRv5※は中国語を中心に学習されており、孤立した手書きのかな1文字を、漢字(元・入・天・之など)に誤読したり、読み落としたりします。高精度版(server)に替えても、かな1文字ではむしろ悪化し(かなの消失が増え、約10倍遅くなる)、単一文字(特に重要なのは、選択肢としてよく使用される「あいうえお、アイウエオ、abcde、12345」など)の推論精度が低下する問題は解決しませんでした。
※PP-OCRv5とは?
PP-OCRv5は、百度(Baidu)のPaddlePaddleチームが公開している無料の文字認識AIです。日本語を含む5種類の文字を、1つのモデルで読み取れます。
このプログラムで使っているのは、公式に公開されている ONNX 形式のモデル(Hugging Face)です。この1つのモデルで、次の5種類の文字を読めるそうです。
- 簡体字中国語
- 繁体字中国語
- ピンイン(中国語の読み記号)
- 英語
- 日本語
手書きの中国語・英語などで、汎用の大規模AI(Gemini 2.5 Pro、GPT-4o など)を上回ったという記事がネット上にはありますが、真偽の程は私にはわかりません。が、このAI自動採点を実際に試して感じたことですが、まずmobile(軽量版)は容量が十分 小さく(16.5MB)、かつ、1解答あたりの処理時間が数十ミリ秒と、動作速度が非常に速い印象を強く受けました。また、GPUが不要で、CPUだけで動くという点も環境負荷が小さいという点でありがたい限りです。
印刷された文字、短い単語、数字の読み取りは「優秀」としか言いようがなく、それが手書き文字になっても推論精度が高く、十分実用的だと(私には)感じられました。
ただ1点、PP-OCRv5は孤立した手書きの日本語のかな1文字を読むのが苦手です。この部分が改善されたら、もう言うことはないのですが・・・
この単一文字の認識に失敗する問題を解決するために導入したのが、単一文字専用の分類器です。単一文字専用の分類器を用意出来れば、推論問題自体を、対象とする候補が数字~数十字程度の文字集合に限られる「易しい問題」へ変換できるため、推論精度の向上が多いに期待できます。
6.2 分類器の構造と学習
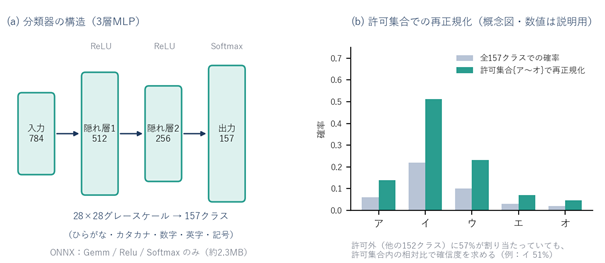
図3 専用分類器の構造(a)と、許可集合による再正規化(b)
- 構造:28×28のグレースケール(784次元)を入力とする3層のMLP(784-512-256-157)です。ONNXの Gemm・Relu・Softmax だけで書き出しており、約2.3MB、推論は1ms前後です。
- なぜCNNではないか:開発環境が32bitのPythonでPyTorchが使えず、scikit-learnの MLPClassifier で学習しています。ONNXへの書き出しは、onnx のヘルパーでノードを並べる自作の処理です。
- 学習データ:ETL文字データベース(産業技術総合研究所)由来の約35万枚、157クラス(数字・ひらがな・カタカナ・英大小文字・記号)及び、独自に収集した手書きの「数字・ひらがな・カタカナ・アルファベット大文字と小文字・記号(○△×)」です。学習データの不均衡を避けるため、1クラス2,000枚に間引きます。回転(±8°)・拡大縮小・平行移動で拡張(水増しデータを作成)します。
- 32bit環境の落とし穴対策:35万枚の画像をリストに append してから配列へ変換する方式を取ると、My PC では連続メモリの確保に失敗することがわかりました。そこで件数を事前に計算し、np.empty へ直接書き込む方式に変え、sklearnの early_stopping(内部で学習データの複製を作る)も無効にして、ようやく学習モデルの生成に成功しました。
6.3 前処理:学習と推論で同じ切り出しにする
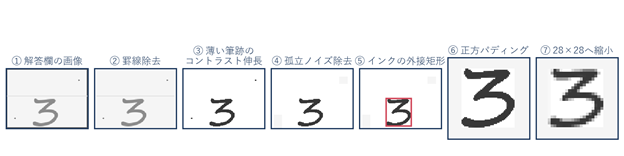
図4 分類器の前処理(合成した模擬画像による説明図。実際の答案画像ではありません)
分類器に渡す前に、解答欄の画像を次の順で整えます。学習のときに見せる画像と、採点のときに見せる画像が「同じ見た目」になるようにするため、学習データの切り出しも、推論と同じ関数で行うことが重要です。この方法を採ることで、後で切り出し方を直したときも、学習データを同じ関数で作り直すだけで、「学習データとしての切り出し画像」と、「採点用に解答欄から切り出した画像」の両方がそろいます。
1. 罫線除去:セル外周付近の、幅や高さの大半を覆う直線を消します。外周帯ではしきい値を緩め、縁から伸びる細い連なりも消します。
2. 薄い筆跡のコントラスト伸長:鉛筆や薄いボールペンを濃くします。
3. 罫線の再除去:伸長で復活した薄い罫線を、もう一度消します。
4. 孤立ノイズ除去:罫線に接した小さなノイズが外接矩形を広げるのを防ぎます。
5. 外接矩形の検出と、印刷ラベルの分離:列方向の大きな空白で分けたグループのうち、最大のインク量のもの(=手書き)だけを残します。
6. 正方パディング:外接矩形を、余白16%を付けた正方形に収めます。
7. 28×28へ縮小:面積平均で縮小し、(255 − 画素) / 255 に正規化します。
実は、この答案画像からの解答欄矩形の切り出しでは、手痛い失敗を経験しています。
当初、用意した画像の切り出し方には不具合があり、解答欄の罫線が混ざったまま切り出されていました。その画像で学習したモデルを作り、その後、罫線が混ざらないように採点側の切り出し方を直しました。すると、学習では「罫線つきの文字」を覚えていたのに、採点では「罫線なしの文字」が来るようになり、新しいモデルのほうが、古いモデルより成績が悪くなりました。
なので、上記前処理の1と3で行っている罫線の除去は極めて重要です。
6.4 許可集合と確信度:選択肢を絞る
これは前回の記事で詳しく書いた内容です。
設問の候補(文字種、または採点者が書いた選択肢)に許可集合を絞り、その中で確率を再正規化して、最も高い文字を答えとします。確信度は「許可集合の中での相対的な確率」です(図3b)。採点基準メモに 選択肢:アイウエオ と書くと、許可集合が選択肢だけになり、選択肢外の字への誤読が構造的に消えます。
旧モデルの内部検証では、同種の全候補(カタカナ46字など)から選ぶと約93.7%、5択に絞ると約98.5%でした。実際の答案での効果は、8章で示します。
ここに、思わぬ落とし穴がありました!
許可文字が1字だけだと、何を書いても一致します。確信度は許可集合内での再正規化なので、許可文字が1字だと定義上つねに1.00になります。実際に「選択肢:ク」と1字だけ指定したところ、43枚すべてが「ク」と判定されました(同じ画像をカタカナ46字で見ると、タ・ウ・ク・ハ・ワ…と割れていました)。対策として、選択肢のうちモデルが知っている文字が2字未満なら選択肢制約を使わず、文字種制約へ戻します。模範解答が選択肢に含まれない場合も同様です。
7.安全設計:誤って ○ を付けない・なるべく自動 × にしない
7.1 安全設計:誤って ○ を付けない
採点で最も避けたいのは、間違いを正解にしてしまうこと(誤自動 ○ )です。次の安全弁を重ねています。ただし、これは誤って正解(○)とする件数が0であることを保証するものではありません。
- 迷ったら人へ:低確信度・判読不能・エラーは、未採点のまま残して「要確認」にします。
- 空欄の保守的な判定:輝度190未満をインクとみなし、比率が0.5%未満のときだけ空欄とします。空欄と断定できない薄い筆跡は、確信度を0.5以下に抑えて要確認へ回します。
- 読めなければ × にしない:かな設問で、文字種制約つきの再読でも「かなを1文字も確認できない」場合(例:「う」が「2」、「い」が「L」に見えた)、無制約の読みを根拠に自動×にはしません。
- 二重確認(⑤):× を付ける前に高精度モデルで再読し、読みが割れたら要確認にします。
- 英単語の長さ整合ガード:英字の設問(英大小文字52字に制約して再読)では、CTC照合の結果が、読み取った文字数と大きく食い違うときは却下します。実手書き812組の検証で、誤自動 ○ が4.80%から0.00%になりました。綴りが惜しい不一致(essential → esyential)も、× ではなく要確認にします。
- 回帰テストの常設:実際の答案セル172枚(4設問×43名)と、目視で確定した正解ラベルに対して、本番と同じ分類処理を呼ぶテストを用意しました。しきい値・前処理・モデルを変えたら必ず実行し、誤自動 ○ が増えていないかを確かめます。
7.2 なるべく自動 × にしない
設計当初の自動 × の扱い:分類器が別の字であると高い確信度(0.90以上)で判定し、不正解(×)とした解答を確認すると、実際には正解(○)である解答が複数個含まれている場合がありました。このことから、一連の採点作業全体では、相当数の正解(○)が自動的に不正解(×)になってしまうことが予想されました。そこで、当初は、自動 × の閾値である ClassifierWrongConfidence = 1.01(実質オフ)にして、解答欄が空欄であることが明らかな場合と、OCRが解答を別の字や語であるとはっきり認識し、複数の照合を通しても模範解答に届かなかった場合以外は自動 × とせず、すべて要確認へ回す安全策を取りました。
ただ、実際に採点作業を行ってみると、今度はあまりにも自動 × が付かなくなり、これは明らかに不正解(×)であると判断できるような解答まで「要確認へ回り過ぎている」という印象を強く受けました(統計的なデータは測定していません)。
そこで、任意のフォルダを指定後、AI自動採点の初回実行時に自動 × の付け方をユーザー自身が選択できるようにプログラムを修正しました。
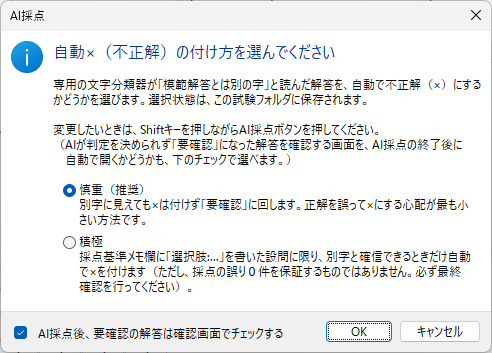
AI自動採点の初回実行時に、ユーザーが自動 × (不正解)の付け方を指定できるよう、次のメッセージを表示し、ユーザーの選択次第では、選択肢制約を設定してある解答の採点時には、機械の判断による積極的な自動 × 判定も実行できるようにしました。案内にある通り、採点作業の途中で、自動 × の扱いを変更することも可能です。また、いったん、自動 × の扱いを設定したフォルダは、次回の採点実行時にも初回採点時にユーザーが行った自動 × の設定が適用されます。
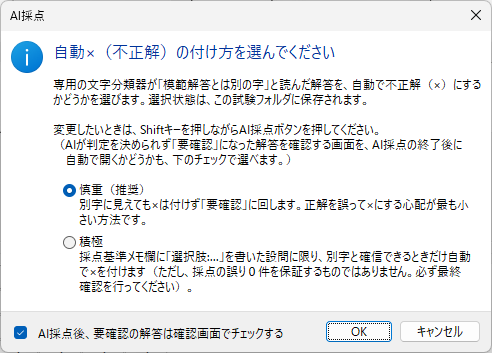
また、要確認に回った解答は別窓でチェックする機能も追加。
8.精度をどう測り、どう改善したか
8.1 測定の原則
- 実際の答案で測る:学習の元データや、それを貼り合わせた合成答案で測ると、精度が実際より良く出てしまいます(見たことのある学習データでテストするのですから、これは言わば不正行為。正解率が良くないわけがありません)。
- 正解ラベルは目視で確定する。
- 学習と評価は人物単位で分ける:同じ人の筆跡が、両方に入らないようにします。
- 有意差はMcNemar検定で確かめる:同じ答案に対する2つのモデルの正誤の食い違い(対応のある2値)を比べる検定です。小さな差を「改善」と言わないためです。
- 「自動 ○ にできた正答数」と「誤自動 ○ 」の両方を見る。その理由は、「取りこぼさない力」と「間違えない力」は、どちらも必要で、片方だけではきちんとした判断できないからです。実際の採点では、間違いを ○ にするほうが、要確認に回すよりずっと問題が大きいので、このプログラムは「誤自動 ○ を増やさない」ことを優先しています。
運用テストで起きた事
自動 ○ にできた正答数は、「正解の答案を、人手なしで正しく ○ にできた件数(取りこぼしの少なさ)」で、これが少ないと、要確認が増えて、採点者の手間が減らないことになります。一方、誤自動 ○ は、「不正解の答案を、誤って○にした件数(間違いの少なさ)」で、これが多いと、間違いが正解になって、生徒の成績が狂うことになります。実際に運用テストであった例として、このプログラムで、偶然、選択肢を1文字だけ指定した実験?(「選択肢:ク」)を行った際、「自動○にできた正答数」は、6件から26件に急増しました(良くなったように見えます)。ところが、原因は判定が甘くなっていたことで、43枚すべてが「ク」と判定されていました。誤自動 ○ の危険があった状態です。もし、正答数だけを見ていたら、「大成功」と勘違いしていました。誤自動 ○ も一緒に見ていたので、素通りに気づけたわけです。
8.2 前処理の修正が決定打だった
「う」(43名)の実データで、分類器が高い確信度で別の字を出す失敗が目立ちました。切り出しを書き出して調べると、43件中30件前後で、解答欄の罫線が外接矩形に取り込まれ、文字がクロップの隅に数pxで写っていました。原因は、罫線判定の「幅の85%以上」というしきい値で、実際の罫線は伸長後でも幅の77%程度しかなく、除去されなかったことです。外周帯では45%で罫線とみなす緩和などを入れた結果が、図5です。
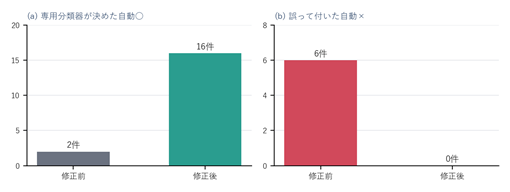
図5 罫線除去の修正の効果(「う」、実生徒43名)
8.3 改善の積み重ね
実際の答案19設問・817件で、専用分類器が模範解答(採点者が事前に登録した、その設問の正解の文字)を出した件数は、次のように積み上がりました(図6)。
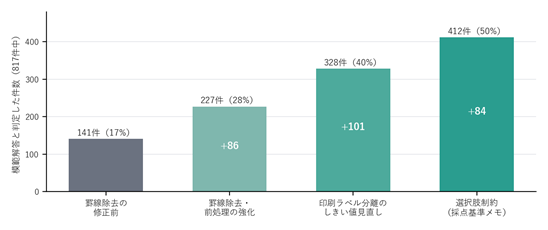
図6 専用分類器が模範解答と判定した件数(817件中)の推移
8.4 選択肢制約の効果
同じ画像・同じ正解ラベルで、カタカナ46字に制約した場合と、選択肢5字(正解:クなら、カキクケコ/正解:イなら、アイウエオ)に制約した場合を比べました(図7)。
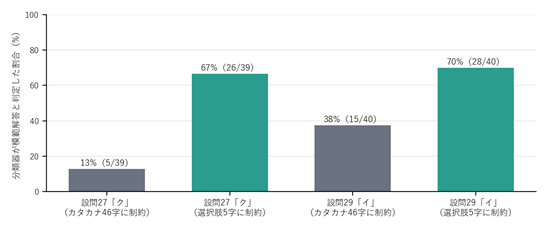
図7 選択肢制約の効果(「ク」39件・「イ」40件、実生徒)
選択肢制約だけの結果を見てはいけない!
「選択肢制約ありの正解数」だけで安全と判断してはいけないことには理由があります。運用試験を繰り返す中で、ラベルの混入した壊れたクロップでも、選択肢を5字に絞ると正解数が増えて見えました(選択肢内で最も近い字を選びやすくなるため)。なので、切り出しが横に広くなっていないか(手書き1文字なら20〜30px、ラベル込みなら60〜100px)を確認したり、制約を広げた場合の結果(選択肢を広げると、偶然の当たりが減るので、正しい実力がわかる)を必ず並べて見る必要があります。
8.5 実手書きデータでの追加学習
学習モデルの性能を良くする最も良い方法は、多種多様な実手書きデータを追加学習させることです。
当初、学習モデルの作成に使用した学習データは公開データ(ETL)が中心で、実際のテストの受験者の筆跡とは特徴量の分布が異なるのは自明です。そこで思い出したのが、数年前に使用目的への同意を得て収集した手書き文字セットの存在でした。幸いなことに、数年前のバックアップデータの中に、それがそっくり残っていました。正直に言うと、今回の開発作業を進める中で(昔、使ったデータがどこかにあったんだけどなー)と思ったことは事実なのですが、今回、提供者の同意を得て、新しく収集した手書き文字セットが相当量あったことと、さらに、数年前に収集した手書き文字セットは、今回使用したものとは、その記入様式(フォーマット)が異なるので、学習用データとして文字を切り出す手間が二重になることから、作業時(昼間は本業があるので作業は大体深夜~早朝にかけて行っています)、ちらっと思い出しただけで、それを探して利用しようとまでは思わなかったのです。
早速、バックアップデータから探し出した機械学習に未使用の手書き文字セットから、現行と同じ解答欄矩形の「切り出し」方法で、手書き数字0~9、カタカナのアイウエオ、アルファベット小文字のabcdeを取り直して学習用データを作成し、追加学習しました。結果は、次の通りです。
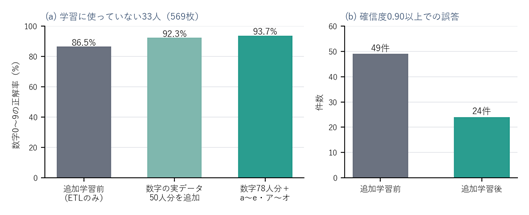
図8 数字の追加学習の効果(学習に使っていない33人・569枚)
選択肢を絞らない場合の小文字(a〜z全体)とカタカナ(46字全体)も、実データ(a〜e、ア〜オ)の追加で大きく改善しました(図9)。
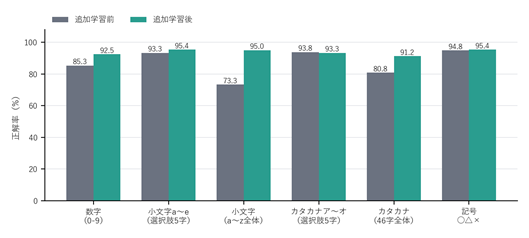
図9 追加学習の前後の比較(学習に使っていない12人。数字は0-9に制約、記号は○△×の3択)
この追加学習を行った後にも、別途、提供者の同意を得て入手できた新しい手書き文字データを用いて、試験の選択肢としてよく利用されると思われる、ひらがなの「あいうえお・かきくけこ・さしすせそ・たちつてと」、カタカナの「アイウエオ・カキクケコ・サシスセソ・タチツテト」の各20文字、アルファベット大文字の「A~Z」26文字について追加学習を行い、学習モデルの推論精度を高めました。
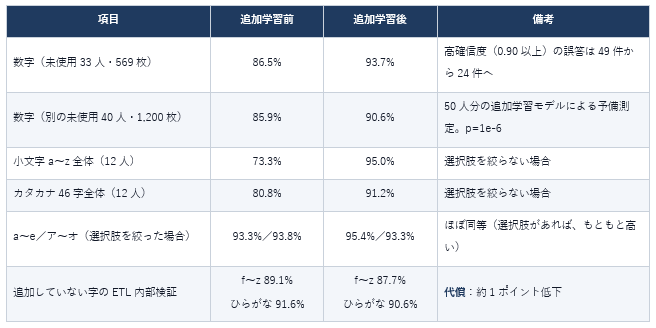
代償として、実データを追加していない字(ひらがな、f〜zなど)が、ETL内部検証で約1ポイント下がりました。実際の答案(「う」)でも、34件から30件(43枚中)に下がっています。ただし、これらは標本が小さく、有意ではないと判断しました。また、実際の試験及び採点では、「ひらがな」が選択肢となる設問設定を出来る限り避ける運用とした方が、この学習モデルを使用した試験の採点については賢明だと思います。
ETLデータベースを利用した学習モデルの配布について(参考)
上記タイトルの件について、その可否を確認するため、産業技術総合研究所のETLデータベースの管理部門の担当者様に以下の3点についての確認をお願いしました。いただいた回答は、次の通りです。
1.ETL文字データベースを学習用データとして作成した学習済みモデルを、無償のソフトウェアに同梱して一般公開することは、ETL文字データベースの利用条件上、問題があるか?
1については「元データの再配布ではありませんので問題ありません。」とのご回答を頂戴しました。
2.学習モデルの公開にあたり、ETL文字データベースを使用したこと、および指定ReferenceをREADME等に明記することで(利用者への説明は)十分か。
2については「それで十分です。」とのご回答を頂戴しました。
3.その他、学習済みモデルを含むソフトウェアを公開するにあたり、ETL文字データベースの利用者として必要となる表示、手続き、または注意事項等がありましたら、ご教示いただきたい。
3については「他に特に手続きはありません。」とのご回答を頂戴しました。
この度、産業技術総合研究所のETLデータベースの管理部門の担当者様には、ご多用の折りにもかかわらず、私の問い合わせに対しまして、迅速かつ丁寧に対応していただけましたこと、心より厚く御礼申し上げます。
9.開発で得た教訓
- 「見かけの改善」に注意する:選択肢を絞ると、壊れたクロップでも成績が良く見えることがありました。クロップ幅や、制約の広い条件を併読する必要があります。
- 修正の優先順位は測って決める:分類器の一致に確信度の下限を入れましたが、実測では1件も救えませんでした。失敗の実像は「正解を低い確信度で出していた」ではなく「別の字が確信度1.00で出ていた」で、その原因は前処理の失敗(罫線の混入)でした。まず、失敗を1件ずつ見ることが大切でした。
- 学習データと推論の前処理を一致させる:壊れた旧切り出しで作った学習データで再学習したモデルは、前処理を直した後に逆転して悪化しました(実生徒で24/43対32/43。旧切り出しとのずれが原因と推定しています)。
- 古い成果物に注意する:ビルドが失敗しても古いexeが残り、テストが「最新の結果」として古い結果を報告する事故がありました。ビルド前に成果物を削除を確認してから判定するようにしました。
10. 運用と設定
しきい値などは LocalAI.ini で調整でき、再ビルドは不要です。主なキーを示します。
| キー | 規定値 | 意味 |
| ConfidenceThreshold | 0.65 | 最終関門。これ未満の判定は「要確認」にする |
| DirectMatchConfidence / KanaMatchConfidence / CandidateMatchConfidence | 0.75 | ①③④で一致したときの確信度の下限 |
| ClassifierMatchConfidence | 0.60 | 分類器の一致を採用するゲート |
| ClassifierMatchFloor | 0.75 | 分類器の一致を採用した後の確信度の下限 |
| ChoiceConstraintEnabled | 1 | 採点基準メモの「選択肢:…」で許可集合を絞る |
| ClassifierWrongConfidence | 1.01 | 別の字を確信して自動×にする確信度(1.01=実質オフ)⇨ ユーザー判断へ変更 |
| CandidateAvgProb / CandidateMinProb | 0.5 / 0.2 | ④のCTC候補照合の採用条件(平均/最低の適合度) |
| BlankDarkLuma / BlankInkRatioMax | 190 / 0.005 | 空欄判定(この輝度未満をインクとみなし、比率が未満なら空欄) |
| LatinLenTolerance | 1 | 英単語設問で許容する文字数の差 |
| SecondModelEnabled | 1 | 高精度モデルとの合議(モデルが無ければ自動で無効) |
運用のコツ
- 記号選択の設問は、採点基準メモに 選択肢:アイウエオ のように選択肢を入力します(2字以上)。効果が最も大きい設定です。
- 解答用紙の解答欄に、小問ラベル(「4:」など)を印刷しない運用(設計)にしてください。ラベルの混入は、分類器の精度を大きく下げます。
- 「要確認」に回った分は人が目視により判定します。ログの理由欄(どの段で迷ったか)も確認すると要確認に回った理由を確認できます。
- 答案の内容によっては、部分点や記述式の意味的な採点を、現状の方式では扱いません(要確認へ回す運用です)。
選択肢制約の入力値について
| 入力 | 扱い |
| 「選択肢:アイウエオ」(全角カナ) | 正しく動く |
| 「選択肢:アイウエオ」(半角カナ) | 「アイウエオ」と同じ(自動で全角に直る) |
| 「選択肢:abcde」(全角英字) | 「abcde」と同じ(自動で半角に直る) |
| 「選択肢:abcde」 | 正しく動く |
| 「選択肢:12345」(全角数字) | 「12345」と同じ(自動で半角に直る) |
| 「選択肢:12345」 | 正しく動く |
11. 今後の課題
- 実生徒データの人数を増やす:人数の多様性が、律速になっている。
- 自動 × の調整:ユーザーによる選択肢制約の設定がない場合でも、自動 × の積極的判定を可能にするか、どうか。
- 部分点・記述式:現在は要確認運用。
- CNN化:64bit環境で学習できれば、さらなる精度向上が見込める?
- 縦書きの答案は、縦列を1文字ずつに分けて認識する方式で対応済み(ただし、分割しきい値は要チューニング)。かつ、動作は未検証。
12. お願いとお断り
このサイトの内容を利用される場合は、自己責任でお願いします。記載した内容を利用した結果、利用者および第三者に損害が発生したとしても、このサイトの管理者は一切責任を負えません。予め、ご了承ください。
AI自動採点機能を搭載した MS_Reader V3 Ver,3.1.0 は次のリンク先記事にあるダウンロードリンクからダウンロードできます。
付録 AI自動採点の実際
1.MS_Reader V3 を起動して採点状態にします。
採点する設問を選択します。下図は設問1が選択されています。
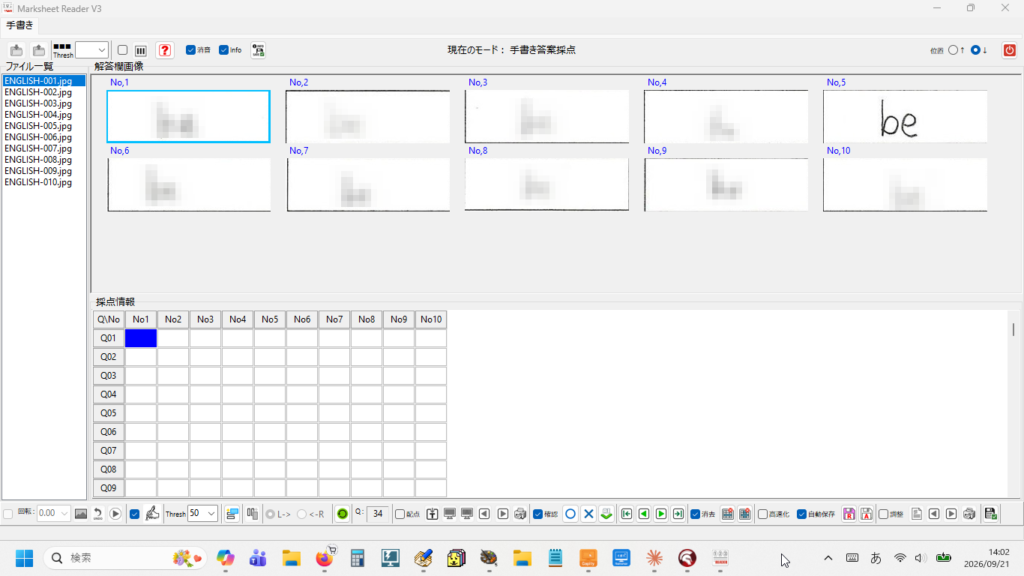
2.AI自動採点ボタンをクリックします。
Shift キーを押しながら、AI自動採点ボタンをクリックすると、「自動 × の付け方」と「AI自動採点で要確認に回された解答を別窓の確認画面でチェック(=目視確認)する機能の利用の有無」を設定する画面を表示できます。
3.模範解答を入力します。
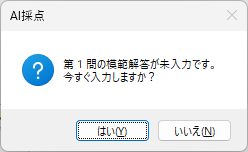
(1) 模範解答が未入力の場合、次のメッセージが表示されます。
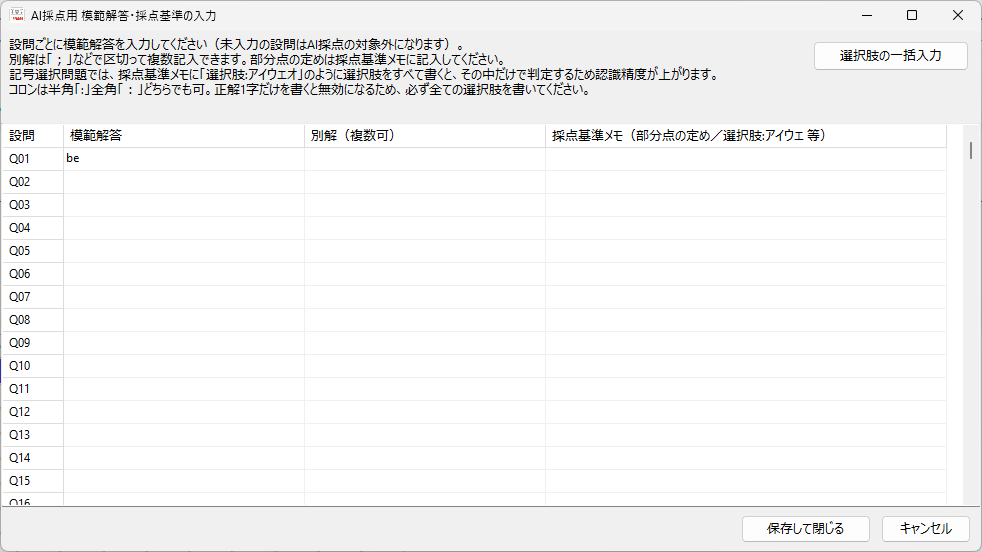
(2) 入力画面が表示されます。設問1の模範解答を入力します。
4.AI自動採点の実行
(1) 採点を実行する場合は「はい」をクリックします。AI自動採点の進行状況は、プログレスバーに表示されます。
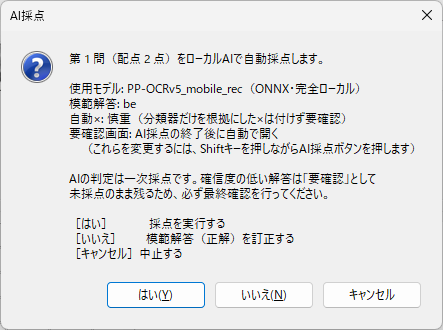
「いいえ」をクリックして、模範解答の再入力
(2) AI自動採点が実行され、初回実行時のみ、採点ログの保存方法を問うメッセージが表示されます。
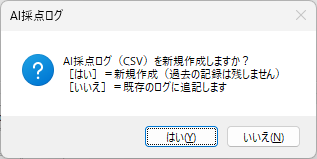
新規作成の場合は「はい」、既存のログに追記する場合は「いいえ」をクリックします。
※ 2回目以降は、AI採点ログに追記するかどうかだけ問われます。
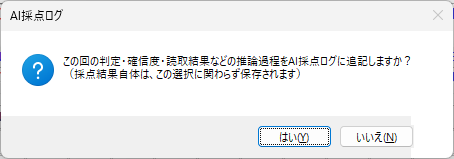
(3) 採点結果が表示されます。
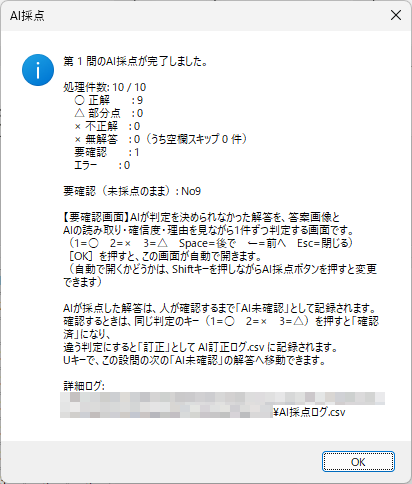
要確認となった解答がある場合、AI採点後に別窓で解答をチェックする設定がONであれば、次のように別窓が開いて、番号順に拡大表示されます。目視による採点を行ってください。
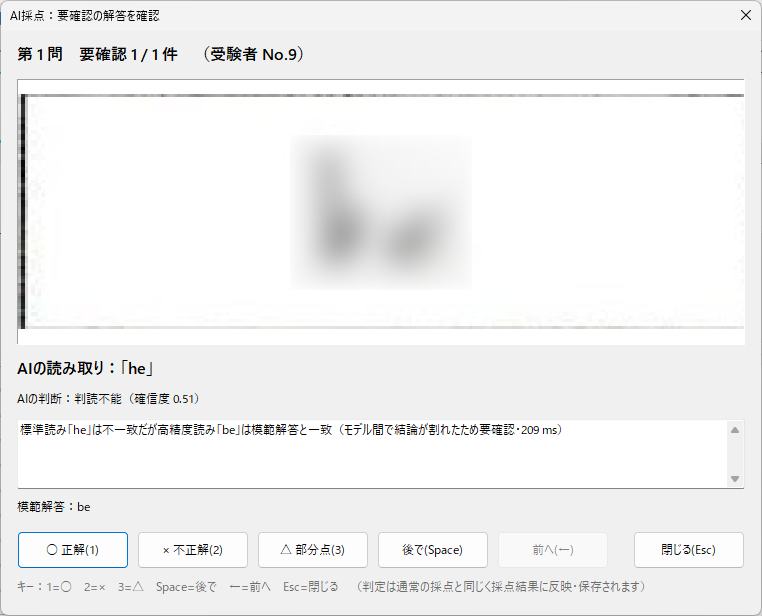
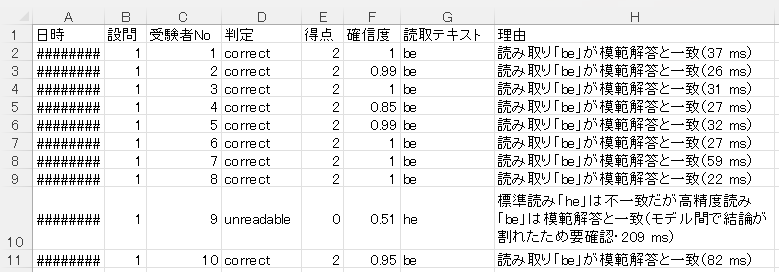
AI採点ログの内容は、次の通りです。
(4) 採点結果を確認します。採点結果を修正する場合は、手動採点する画像をクリックして選択し、正解なら「1」キー、不正解なら「2」キー、部分点ありなら「3」キーを押し下げします。採点結果は、デフォルト設定では自動保存されます。「4」キー押し下げで採点結果を取り消すこともできます。
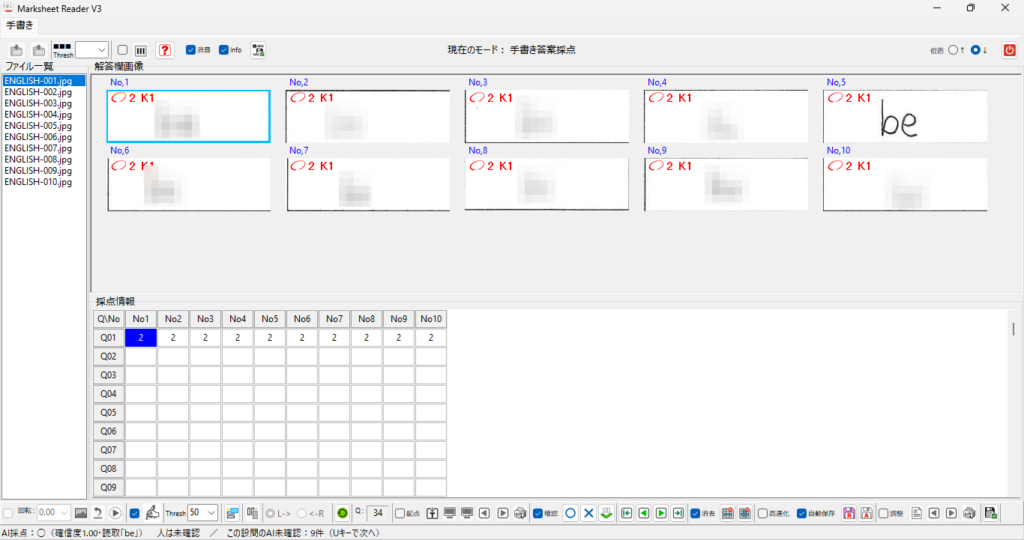
採点実施後の状態です。
5.次の設問に移動します。
グリッドコントロールの設問2のセルをクリックするか、データの移動ボタンをクリックして、次に採点するデータを表示します。
6.選択肢を制約(範囲を限定)する場合の設定方法
選択肢が「例:アイウエオ」の場合、推論する範囲を予め、この5文字に限定することで、推論の成功率を(何もしないよりは)高めることが出来ます。
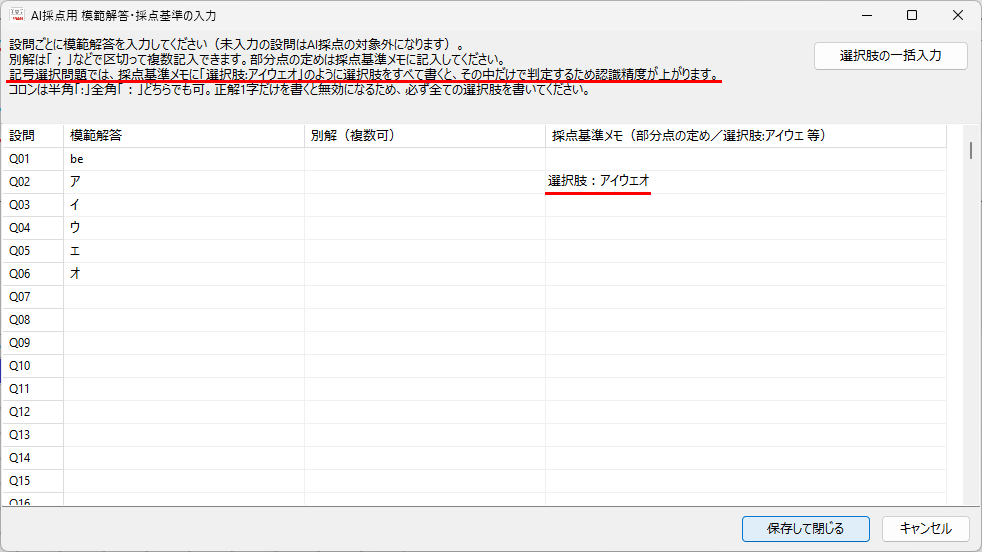
「いちいち設定するのは面倒だ」というユーザーの声が聞こえたように思いましたので、設定が必要な箇所を自動で判定し、一括で選択肢制約を設定出来るようにしました。
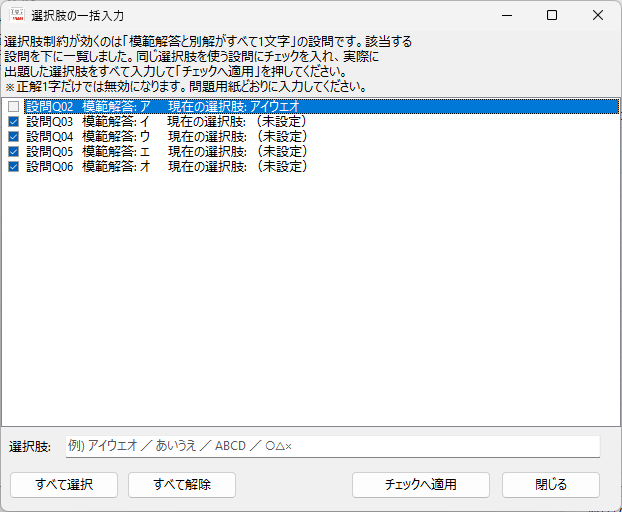
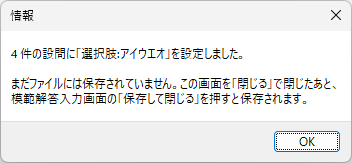
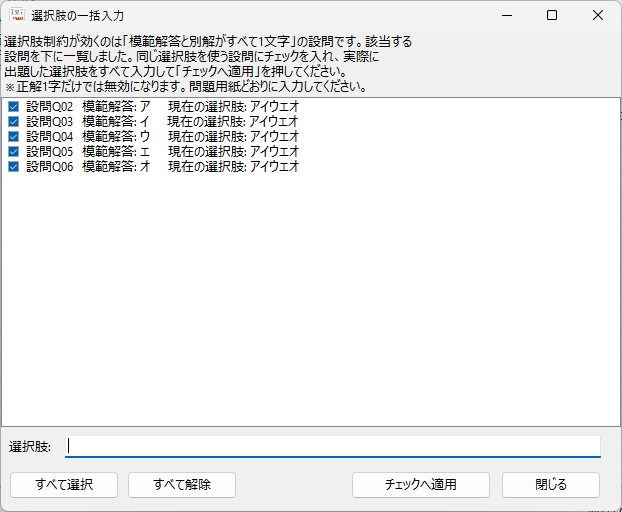
模範解答を一通り入力した後、ダイアログ右上にある「選択肢の一括入力」ボタンをクリックすることで、選択肢制約を一括設定できます(ただし、この機能は使い方を誤ると、設定済みの選択肢制約を自動的に書き換えてしまうことになりますので、使用の際は細心の注意が必要です!)。